
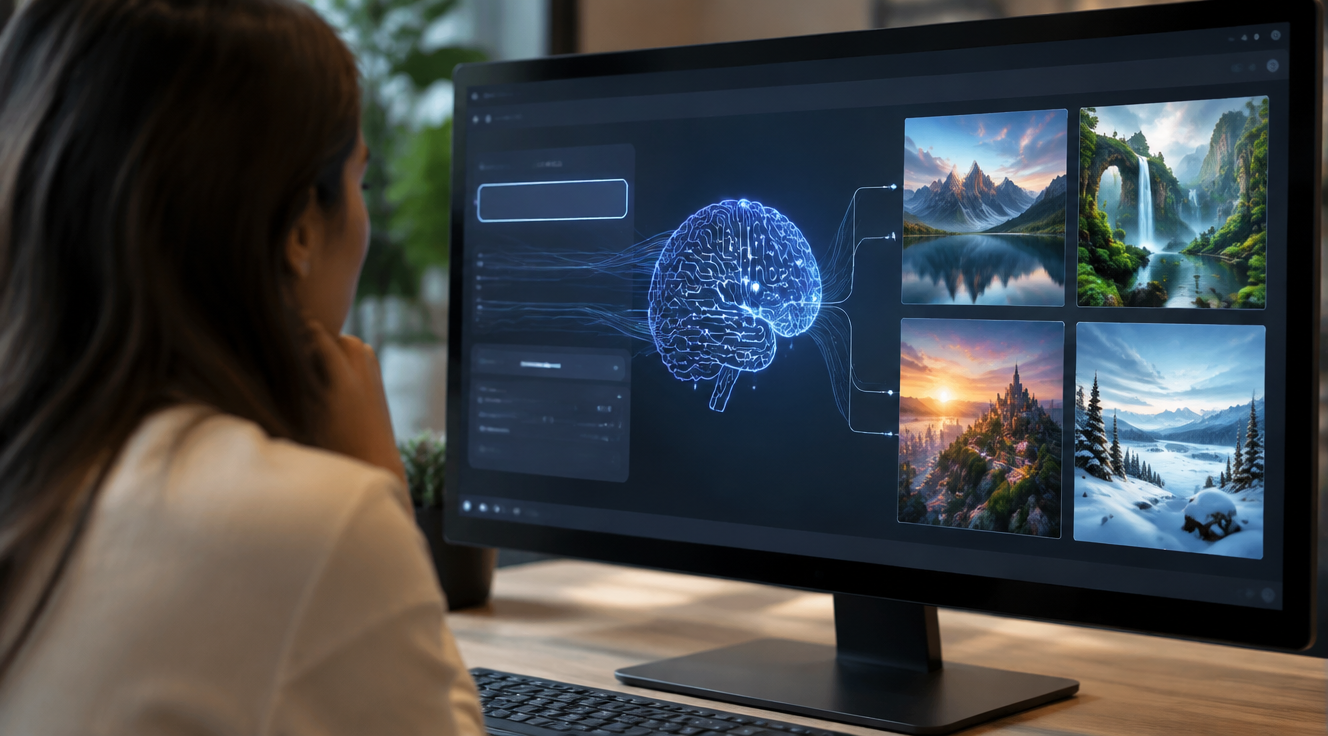
Încerci în casetă de text: „un pisică portocalie citind o carte într-un bibliotecă vechi, stil pictură la ulei”. Apasă Enter. În câteva secunde, apar patru variante. Nicio mână nu a desenat nimic. Totuși, rezultatul seamănă izbitor cu o imagine pe care un artist o putea realiza într-o zi întreagă.
Generarea de imagini AI nu este magie. Este un lanț de pași tehnici, fiecare cu o logică proprie. Înțelegerea lor nu necesită o diplomă în informatică, dar necesită răbdare și câteva analogii concrete.
Ce primește modelul de fapt
Când scrii un prompt, textul nu intră direct într-un desenator. Mai întâi trece printr-un proces numit tokenizare. Sistemul descompune fraza în fragmente mici, numite tokeni, asemănătoare cu bucăți de cuvinte. „pisică” devine un token, „portocalie” altul, „bibliotecă” încă unul.
Un model numit encoder transformă apoi acești tokeni într-o reprezentare matematică. Gândește-te la o hartă mentală a sensurilor: cuvântul „pisică” se apropie pe această hartă de „felin”, „blană”, „mâțe”, dar se îndepărtează de „mașină” sau „pâine”. Această hartă se numește spațiu latent semantic. Modelul învață din milioane de perechi imagine-text să înțeleagă ce înseamnă fiecare cuvânt în contextul vizual.
Spațiul latent: o bibliotecă a tuturor imaginilor posibile
Aici vine partea mai abstractă. Modelul nu lucrează direct cu pixeli, ci într-un spațiu latent, o zonă matematică în care fiecare imagine posibilă are un loc. O imagine clară, bine desenată, corespunde unui punct. O imagine zgomotoasă, confuză, corespunde altui punct, undeva la marginea spațiului.
Generarea începe de obicei cu un „zgomot pur”, o imagine aleatorie, ca un ecran de televizor vechi fără semnal. Din acest zgomot, modelul începe treptat să extragă forme. Prima secundă arată doar nori de culori. Apărea un contur vag. Apoi o față, un obiect, un fundal. Procesul se numește denoising, îndepărtarea zgomotului.
Difuzia inversă: cum se naște imaginea
Majoritatea modelelor moderne de generare, de la Stable Diffusion la DALL-E, folosesc o tehnică numită difuzie inversă. În timpul învățării, modelul a fost antrenat să adauge treptat zgomot unei imagini reale, până când aceasta devenea complet haotică. Apoi, modelul a învățat să inverseze procesul: să transforme zgomotul înapoi într-o imagine coerentă.
La momentul generării, sistemul pornește de la zgomot și aplică zeci de pași mici de rafinare. La fiecare pas, modelul consultă harta semantică a promptului tău și decide cum să ajusteze imaginea. Dacă ai scris „pisică portocalie”, modelul accentuează tonurile portocalii în regiunile care semănă cu o pisică. Dacă ai menționat „stil pictură la ulei”, textura pixelilor capătă aspectul periei.
Numărul de pași contează. Mai puțini pași înseamnă viteză, dar și mai multă incertitudine. Mai mulți pași dau rezultate mai fine, dar costă timp de calcul. Majoritatea utilizatorilor aleg între 20 și 50 de pași, un compromis între calitate și viteză.
Promptul ca ghid, nu ca comandă
Un detaliu important: modelul nu înțelege limba umană la fel ca tine. Nu „știe” ce înseamnă „frumos” sau „epic”. În schimb, asociază cuvintele cu pattern-uri vizuale învățate din datele de antrenament. Cuvântul „cinematic” apare în descrieri de imagini cu lumini dramate, umbre lungi și compoziții largi. Cuvântul „flat” apare în descrieri de ilustrații cu culori uniforme și fără umbre.
Aceasta explică de ce prompturile lungi, cu detalii specifice, funcționează mai bine decât cele scurte. „Pisică portocalie” dă o pisică portocalie. „Pisică portocalie, blana ei lungă și moale, ochi verzi, șezând pe o masă de lemn masiv, lumina unei ferești din stânga, stil realism fotografic, 8K” dă o imagine cu mult mai precisă, pentru că fiecare cuvânt restricționează spațiul latent în care modelul caută răspunsul.
Atenția și arhitectura de tip transformer
În spatele scenelor, modelul folosește o arhitectură numită transformer, aceeași familie de tehnologii folosită în traducerile automate și chatboturi. Mecanismul central se numește atenție. La fiecare pas de generare, modelul „arată” simultan la mai multe zone ale imaginii și la mai multe cuvinte din prompt, comparând ce se potrivește.
Imaginea se construiește astfel prin repetiție: zgomot, ajustare, zgomot, ajustare, până când pixelii se așază într-un desen coerent. Fiecare ajustare este un calcul matematic, o înmulțire de matrici uriașe, efectuată pe procesoare specializate numite GPU-uri. O singură imagine poate implica miliarde de operații.
Unde se ascund limitele
Generarea de imagini AI are puncte slabe clare. Degetele rămân un test clasic: modelele confundă uneori numărul și poziția lor. Textul scris în interiorul imaginii, un panou, un carticel, un logo, apare adesea distorsionat. Obiectele cu simetrie complexă, roțile, oglinzile, pot ieși deformate.
Motivul este simplu: modelul nu înțelege fizica lumii. Nu „știe” că o pisică are patru picioare sau că un pahar de sticlă trebuie să fie transparent. Învățat din imagini, reproduce pattern-uri statistice, nu reguli. Când patternul nu e clar în datele de antrenament, rezultatul devine haos estetic.
Există și o limită etică. Modelele sunt antrenate pe colecții uriașe de imagini, multe dintre ele publicate fără permisiunea explicită a autorilor. Această problemă alimentează dezbateri continue în jurul drepturilor de autor și al creditului artistic.
De la zgomot la imagine: un exemplu concret
Să parcurgem un prompt simplu: „o casă de lemn într-o pădure de iarnă”.
- Tokenizarea descompune fraza în: „o”, „casă”, „de”, „lemn”, „într-o”, „pădure”, „de”, „iarnă”.
- Encoderul transformă tokenii într-un vector semantic, o rețea de relații între concepte.
- Sistemul generează un zgomot aleatoriu de aceeași rezoluție cu imaginea dorită, de exemplu 1024 pe 1024 pixeli.
- În primii pași, zgomotul se organizează în zone de culoare: un fundal albicios pentru zăpadă, tonuri închise pentru copaci.
- În pașii intermediari, apare conturul unei case, un acoperiș, ferestre. Modelul verifică continuu: „corespunde acest fragment descrierii de casă de lemn?”
- În pașii finali, se adaugă detalii: scânduri, fum din coș, lumini calde în ferestre, umbre lungi ale iernii.
- Imaginea finală apare pe ecran, gata de descărcat.
Întregul proces durează între câteva secunde și un minut, în funcție de puterea calculatorului și de complexitatea promptului.
Ce poți face cu această înțelegere
Știind cum funcționează generarea de imagini AI, poți schimba modul în care folosești aceste instrumente. Un prompt bun nu este un text literar, ci o listă de restricții vizuale. Fiecare cuvânt elimină variante posibile din spațiul latent. Cuvântul „iarnă” elimină verdele ierbilor. Cuvântul „lemn” elimină cărămida și betonul.
Încearcă asta: ia un prompt care ți-a dat rezultate slabe și desparte-l în două. Generează imaginea cu jumătate din descriere, apoi cu cealaltă jumătate. Compară ce a lipsit în fiecare variantă. Astfel înveți care cuvinte aduc detalii valoroase și care doar încarcă modelul cu informații contradictorii.
Un alt exercițiu util: generează aceeași imagine de trei ori, fără să schimbi nimic. Rezultatele vor fi diferite, pentru că zgomotul inițial este aleatoriu. Observă ce rămâne constant și ce variază. Acolo vezi granița dintre ce controla tu prin prompt și ce lasă modelul la discreția lui.
Generarea de imagini AI nu înlocuiește gândirea vizuală. O transformă. În loc să desenezi tu fiecare linie, gândești în cuvinte și apoi verifici ce a construit modelul din acele cuvinte. E un dialog, nu un monolog. Și ca orice dialog, merită practică.
